



Dans le paysage moderne du développement de logiciels d’entreprise, l’intégration de modèles de langage volumineux (LLM) dans des outils de diagrammation et de codage comme VPasCode est un véritable changement de paradigme. Cependant, l’adoption de ces puissantes capacités d’IA nécessite plus qu’une simple clé API. Elle exige une architecture robuste qui équilibre l’innovation avec une gouvernance stricte des données, la sécurité et l’optimisation des performances.
Ce tutoriel explore l’architecture « Support des points de terminaison AI personnalisés » présente dans VPasCode. Nous parcourrons ensemble comment les organisations peuvent passer d’une utilisation générique et publique de l’IA à une infrastructure entièrement gérée de niveau entreprise. En configurant des points de terminaison personnalisés, vous obtenez un contrôle total sur l’endroit où vos données sont envoyées, la manière dont elles sont traitées, et la façon dont votre équipe interagit avec la génération de diagrammes assistée par IA.
L’architecture d’intégration d’entreprise
Les outils d’IA standard acheminent souvent toutes les requêtes des utilisateurs via un fournisseur de cloud public central. Bien que pratique, cela peut présenter des risques importants pour les organisations traitant de propriété intellectuelle sensible ou de données réglementées. VPasCode résout ce problème en vous permettant de définir unPoint de terminaison AI personnalisé.
Cette fonctionnalité permet une connexion directe entre l’infrastructure AI approuvée de votre organisation et l’environnement VPasCode. Au lieu d’envoyer des données vers une API publique générique, vos requêtes sont acheminées via une URL spécifique et gérée. Cette architecture prend en charge une approche « Apportez Votre Propre Modèle » (BYOM), vous permettant d’exploiter :
- Relations avec des fournisseurs existants :Continuez à utiliser vos contrats actuels avec des fournisseurs comme OpenAI, Anthropic ou Google.
- Infrastructure interne :Orientez le système vers vos propres LLM auto-hébergés exécutés sur des clouds privés ou des serveurs sur site.
- Diversité des modèles :Accédez à une large gamme de modèles, y compris DeepSeek, Mistral, Qwen, et des points de terminaison cloud spécialisés de niveau entreprise.
Étape par étape : Configuration de la connexion LLM
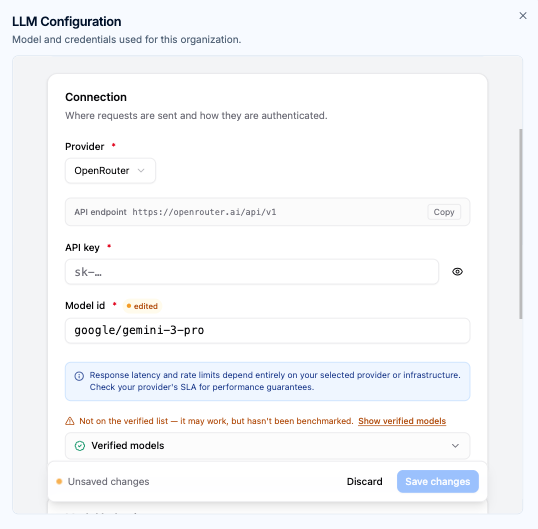
La configuration d’un point de terminaison personnalisé implique la cartographie de trois piliers critiques : l’authentification, le routage et la sélection du modèle. Décomposons l’interface de configuration illustrée dans le diagramme.
1. Définir le fournisseur de connexion
La première étape consiste à identifier leFournisseur. Dans le panneau de configuration, vous sélectionnez le service qui héberge votre modèle. Ce n’est pas simplement une étiquette ; cela détermine le protocole d’authentification attendu et la structure du point de terminaison. Par exemple, si vous sélectionnez « OpenRouter », le système comprend le format d’API spécifique requis pour cet agrégateur.
2. Spécifier le point de terminaison API
LePoint de terminaison API est le cœur de cette configuration. Il s’agit de l’URL spécifique où les requêtes HTTP seront envoyées. Par défaut, VPasCode peut pointer vers un emplacement standard, mais pour un support personnalisé, vous entrez l’URL de passerelle spécifique de votre organisation (par exemple,https://your-internal-gateway.ai/api/v1).
Pourquoi cela compte : Cela garantit que les données sensibles ne traversent jamais l’internet public vers un serveur tiers sauf autorisation explicite. Cela vous permet également d’acheminer le trafic via un proxy d’entreprise ou un équilibreur de charge spécifique conçu pour vos charges de travail d’IA.
3. Gérer l’authentification (clés API)
La sécurité est primordiale. LeClé API le champ vous permet de saisir les identifiants requis pour authentifier vos requêtes. VPasCode gère cela de manière sécurisée, garantissant que votre clé est stockée en toute sécurité dans la configuration de l’espace de travail.
En utilisant une clé API dédiée, vous activez Gestion dédiée des API. Cela permet à votre organisation de :
- Suivre l’utilisation par équipe ou projet spécifique.
- Faire respecter les journaux d’audit de sécurité internes.
- Gérer efficacement les limites de débit et les quotas d’utilisation.
4. Sélection de l’ID de modèle
Une fois la connexion établie, vous devez spécifier l’« ID de modèle. Il s’agit de l’identifiant unique du modèle de langage spécifique que vous souhaitez utiliser. Dans la configuration d’exemple, google/gemini-3-pro est sélectionné.
VPasCode permet une sélection de modèle sur mesure, ce qui signifie que vous pouvez choisir le modèle qui correspond à vos exigences techniques spécifiques :
- Modèles à haut débit :Idéaux pour une itération rapide, la génération simple de diagrammes ou l’analyse rapide de code.
- Modèles à fort raisonnement :Essentiels pour la conception d’architectures multi-niveaux complexes, la logique de code complexe ou la génération de diagrammes de système très précis.
Gouvernance et sécurité opérationnelle
La configuration d’extrémités personnalisées ne concerne pas seulement la connectivité ; il s’agit de maintenir le contrôle sur le comportement de l’IA et sur la stabilité du système.
Gouvernance de l’espace de travail
Grâce à la fonctionnalité « Gouvernance centralisée de l’espace de travail», les gestionnaires d’espaces de travail peuvent établir des configurations d’IA à l’échelle de l’espace de travail. Cela garantit que chaque membre de l’équipe opère selon les mêmes normes opérationnelles, utilise les mêmes modèles approuvés et respecte les mêmes politiques de données. Cela empêche l’utilisation d’une « IA ombre » où des individus pourraient se connecter à des extrémités non vérifiées et non sécurisées.
Configuration comportementale
Une fois un modèle connecté, vous pouvez appliquer « Configuration comportementale avancée. Cela permet aux administrateurs d’affiner les paramètres de sortie, tels que :
- Nombre maximal de jetons de sortie : Limiter la longueur du contenu généré pour éviter la prolixité.
- Effort de raisonnement : Ajuster le « raisonnement » computationnel requis pour les tâches complexes par rapport aux tâches simples.
Retour automatique du système
La fiabilité est cruciale dans les flux de travail de développement. La Retour automatique du système fonctionnalité garantit que si votre routage personnalisé est désactivé ou si le point de terminaison externe devient inaccessible, le système ne plante pas. Au lieu de cela, il bascule instantanément vers l’infrastructure IA par défaut de Visual Paradigm, maintenant une disponibilité opérationnelle continue.
Résumé
En exploitant le support des points de terminaison IA personnalisés dans VPasCode, les organisations peuvent transformer leurs outils de diagrammation en moteurs sécurisés, conformes et hautement efficaces pour le développement logiciel. Vous passez d’une assistance IA générique à une solution sur mesure de niveau entreprise qui respecte vos politiques de données tout en dotant votre équipe des dernières capacités d’IA générative.